- Хост
- gw.prokso.com
- Порт
- 823 HTTP · 824 SOCKS5 — новый IP на каждый запрос · 10000–20000 фиксированный IP (sticky-сессия), HTTP(S) и SOCKS5
- Логин и пароль
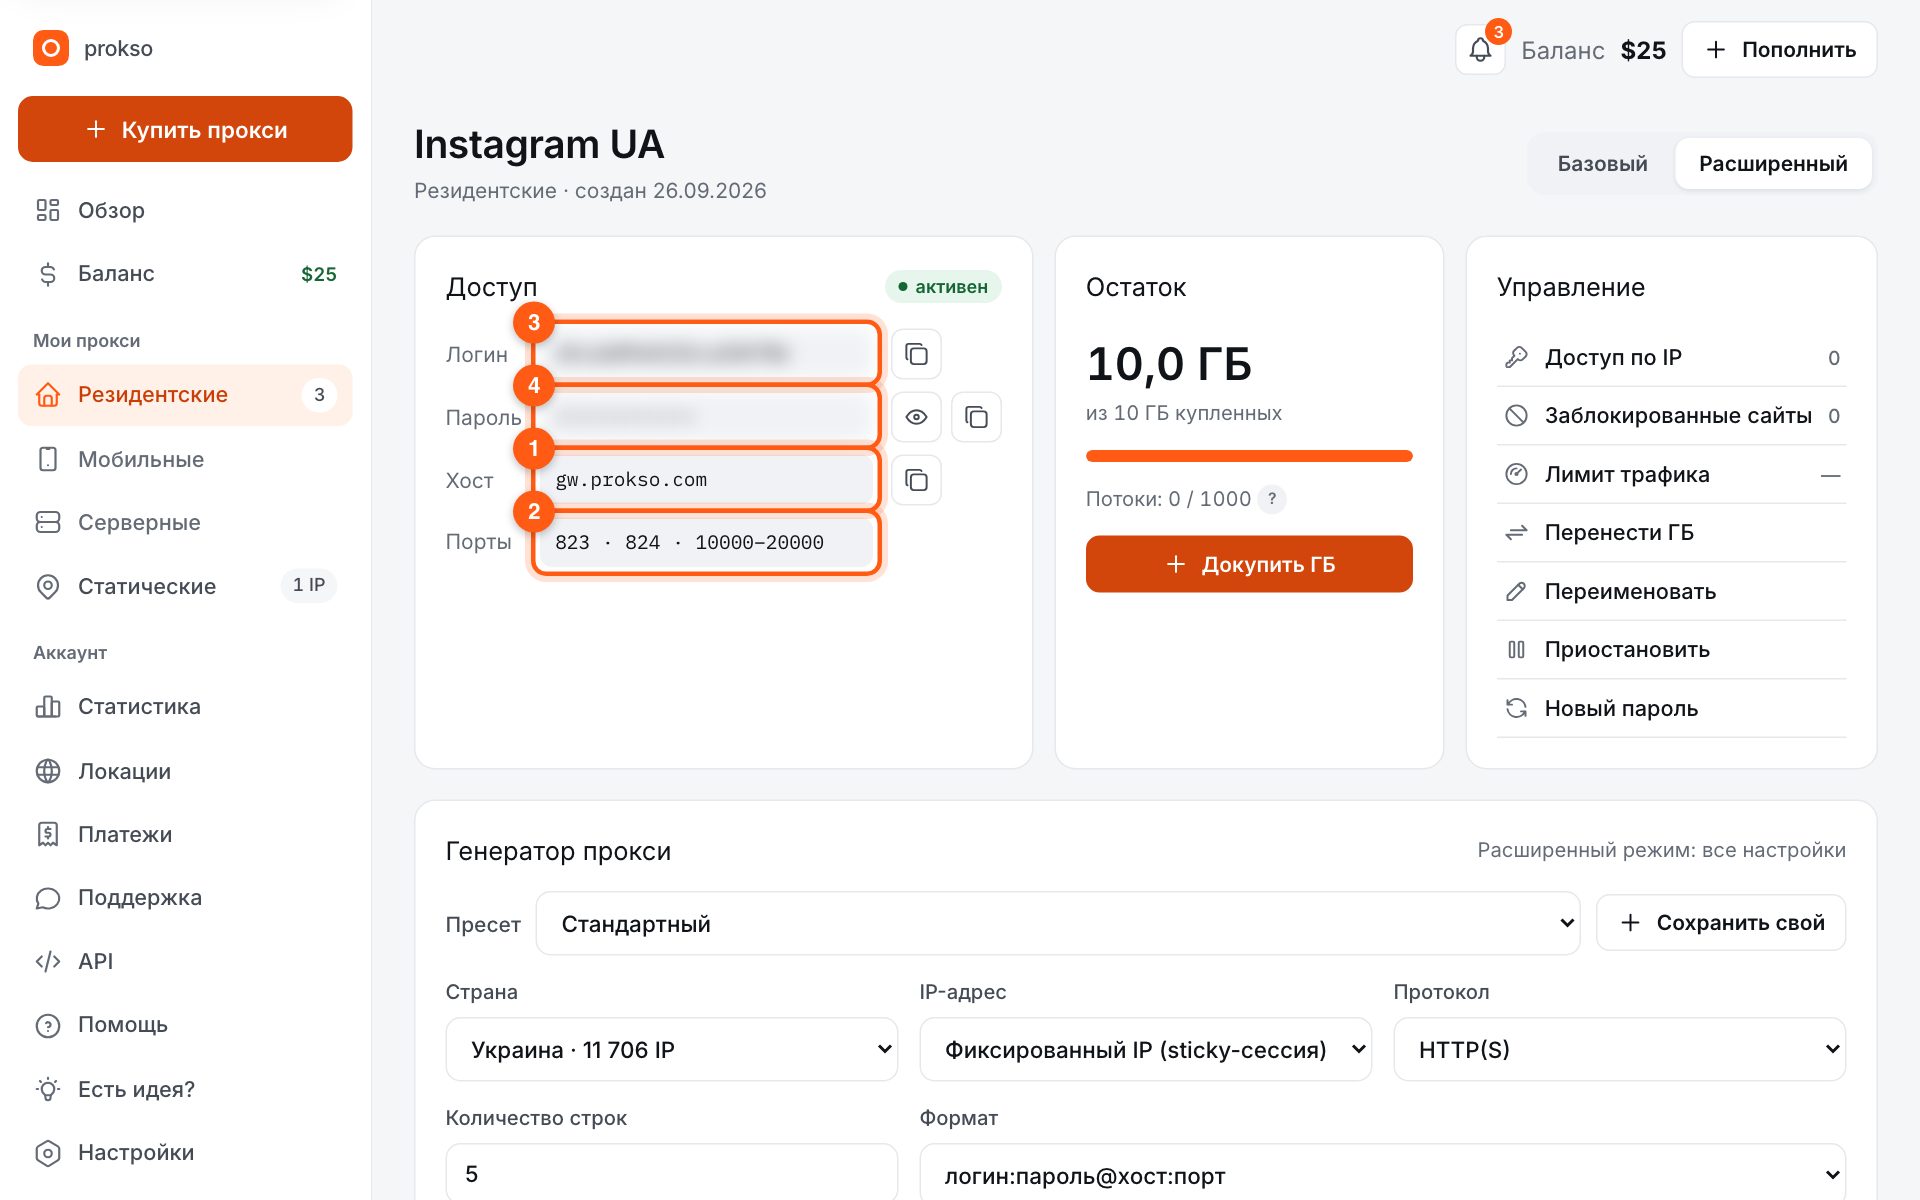
- в кабинете, на странице плана
Готовые строки в нужном формате генерирует кабинет: выберите страну, тип IP и протокол.
- Хост — gw.prokso.com, порты 823 (HTTP), 824 (SOCKS5), 10000–20000 (фиксированный IP, HTTP или SOCKS5)
- Логин и пароль — в кабинете на странице плана
- Проверяйте IP в ответе самого запроса через прокси: страница «Мой IP» в браузере ваш скрипт не проверяет
Пошаговая инструкция, как подключить прокси Prokso в Scrapy. Займёт несколько минут.
Шаг 1. Возьмите данные прокси в кабинете
Откройте план и скопируйте хост gw.prokso.com, порт, логин и пароль. Порт 823 — HTTP, 824 — SOCKS5 (оба дают новый IP на каждый запрос); порты 10000–20000 — фиксированный IP до 120 минут, работают и как HTTP, и как SOCKS5 (каждый порт — отдельный адрес). Страну задают в логине: логин__cr.ua.
Шаг 2. Проверьте, что HttpProxyMiddleware включён
В Scrapy он работает по умолчанию (HTTPPROXY_ENABLED = True), ничего дополнительно устанавливать не нужно. Если вы отключали его в settings.py, верните.
Шаг 3. Передайте прокси в meta запроса
Укажите meta={"proxy": ...} с логином и паролем прямо в адресе. Scrapy сам превратит их в заголовок авторизации для прокси. Порт 823 даёт новый IP на каждый запрос.
import scrapy

PROXY = "http://ЛОГИН:ПАРОЛЬ@gw.prokso.com:823"

class IpSpider(scrapy.Spider):
    name = "ip"

    def start_requests(self):
        yield scrapy.Request("https://api.ipify.org?format=json",
                             meta={"proxy": PROXY})

    def parse(self, response):
        yield response.json()
Шаг 4. Фиксированные IP для сессий
Если паук логинится или ходит по страницам, где важен один IP, распределите запросы по фиксированным портам 10000–20000: одна сессия — один порт.
# one sticky port per account
PORTS = [10001, 10002, 10003]

def proxy_for(i):
    return f"http://ЛОГИН:ПАРОЛЬ@gw.prokso.com:{PORTS[i % len(PORTS)]}"

# in the request: meta={"proxy": proxy_for(i)}
Шаг 5. Проверьте IP в результате
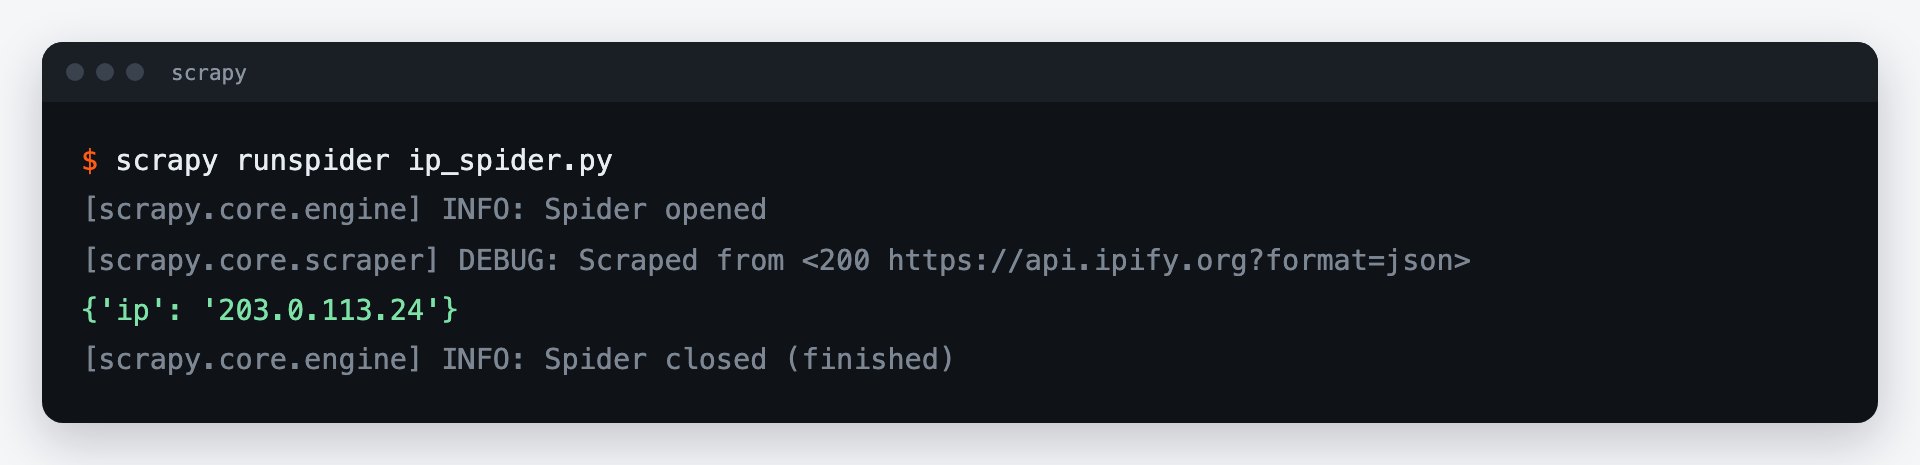
Сохраните паука из примера в файл ip_spider.py и запустите scrapy runspider ip_spider.py. Он обратится к https://api.ipify.org и выведет в лог собранный элемент с IP — это должен быть IP прокси, а не ваш.
Настройки проекта под работу через прокси
Стандартные значения Scrapy рассчитаны на прямое соединение. Через прокси стоит уменьшить число одновременных запросов к одному сайту, включить автоматическую подстройку скорости и ограничить повторы:
# settings.py
CONCURRENT_REQUESTS = 8
CONCURRENT_REQUESTS_PER_DOMAIN = 4
DOWNLOAD_TIMEOUT = 30
AUTOTHROTTLE_ENABLED = True          # slows down when the site responds slowly
RETRY_TIMES = 2
RETRY_HTTP_CODES = [502, 503, 504, 408]
COMPRESSION_ENABLED = True           # compressed responses use less traffic
В RETRY_HTTP_CODES оставьте только временные сбои. Коды 403 и 429 приходят от сайта: повторять их сразу бессмысленно, а трафик тратится на каждый ответ.
Прокси для всех запросов сразу
Чтобы не писать meta в каждом запросе, добавьте прокси в небольшом промежуточном обработчике. Он должен стоять раньше встроенного HttpProxyMiddleware:
# middlewares.py
class ProksoProxyMiddleware:
    def process_request(self, request, spider):
        request.meta.setdefault("proxy", spider.settings["PROXY_URL"])

# settings.py
PROXY_URL = "http://USERNAME:PASSWORD@gw.prokso.com:823"
DOWNLOADER_MIDDLEWARES = {"myproject.middlewares.ProksoProxyMiddleware": 350}
Как тратить меньше трафика
Scrapy загружает только HTML, без картинок и скриптов, поэтому сам по себе расходует немного. Основные потери — повторные обходы. Включите HTTPCACHE_ENABLED на время отладки паука: страницы будут браться с диска, а не через прокси. Перед запуском оцените объём в калькуляторе трафика.
Вопросы и ответы
Можно ли задать прокси для всего проекта сразу?
Да: HttpProxyMiddleware читает переменные окружения <code>http_proxy</code> и <code>https_proxy</code>. Но значение в <code>meta</code> имеет приоритет, так что для отдельных запросов его можно переопределить.
Что делать с ошибками 407?
Это значит, что прокси не принял логин или пароль. Скопируйте их ещё раз со страницы плана и проверьте, что в пароле нет символов, которые нужно кодировать в URL.
Как менять IP на каждом запросе?
Ничего делать не нужно: порт 823 выдаёт новый IP на каждый запрос. Пул прокси и отдельные расширения для ротации не требуются.
Сайт отвечает 403 на все запросы. Дело в прокси?
Обычно нет: это ответ сайта. Проверьте заголовки запроса, в первую очередь User-Agent, уменьшите скорость и попробуйте другой тип прокси. Подробнее — на странице <a href="/ru/errors/403-forbidden">ошибки 403</a>.
Работает ли прокси со scrapy-playwright?
Да, но прокси там задаётся в параметрах запуска браузера, а не через <code>meta["proxy"]</code>.