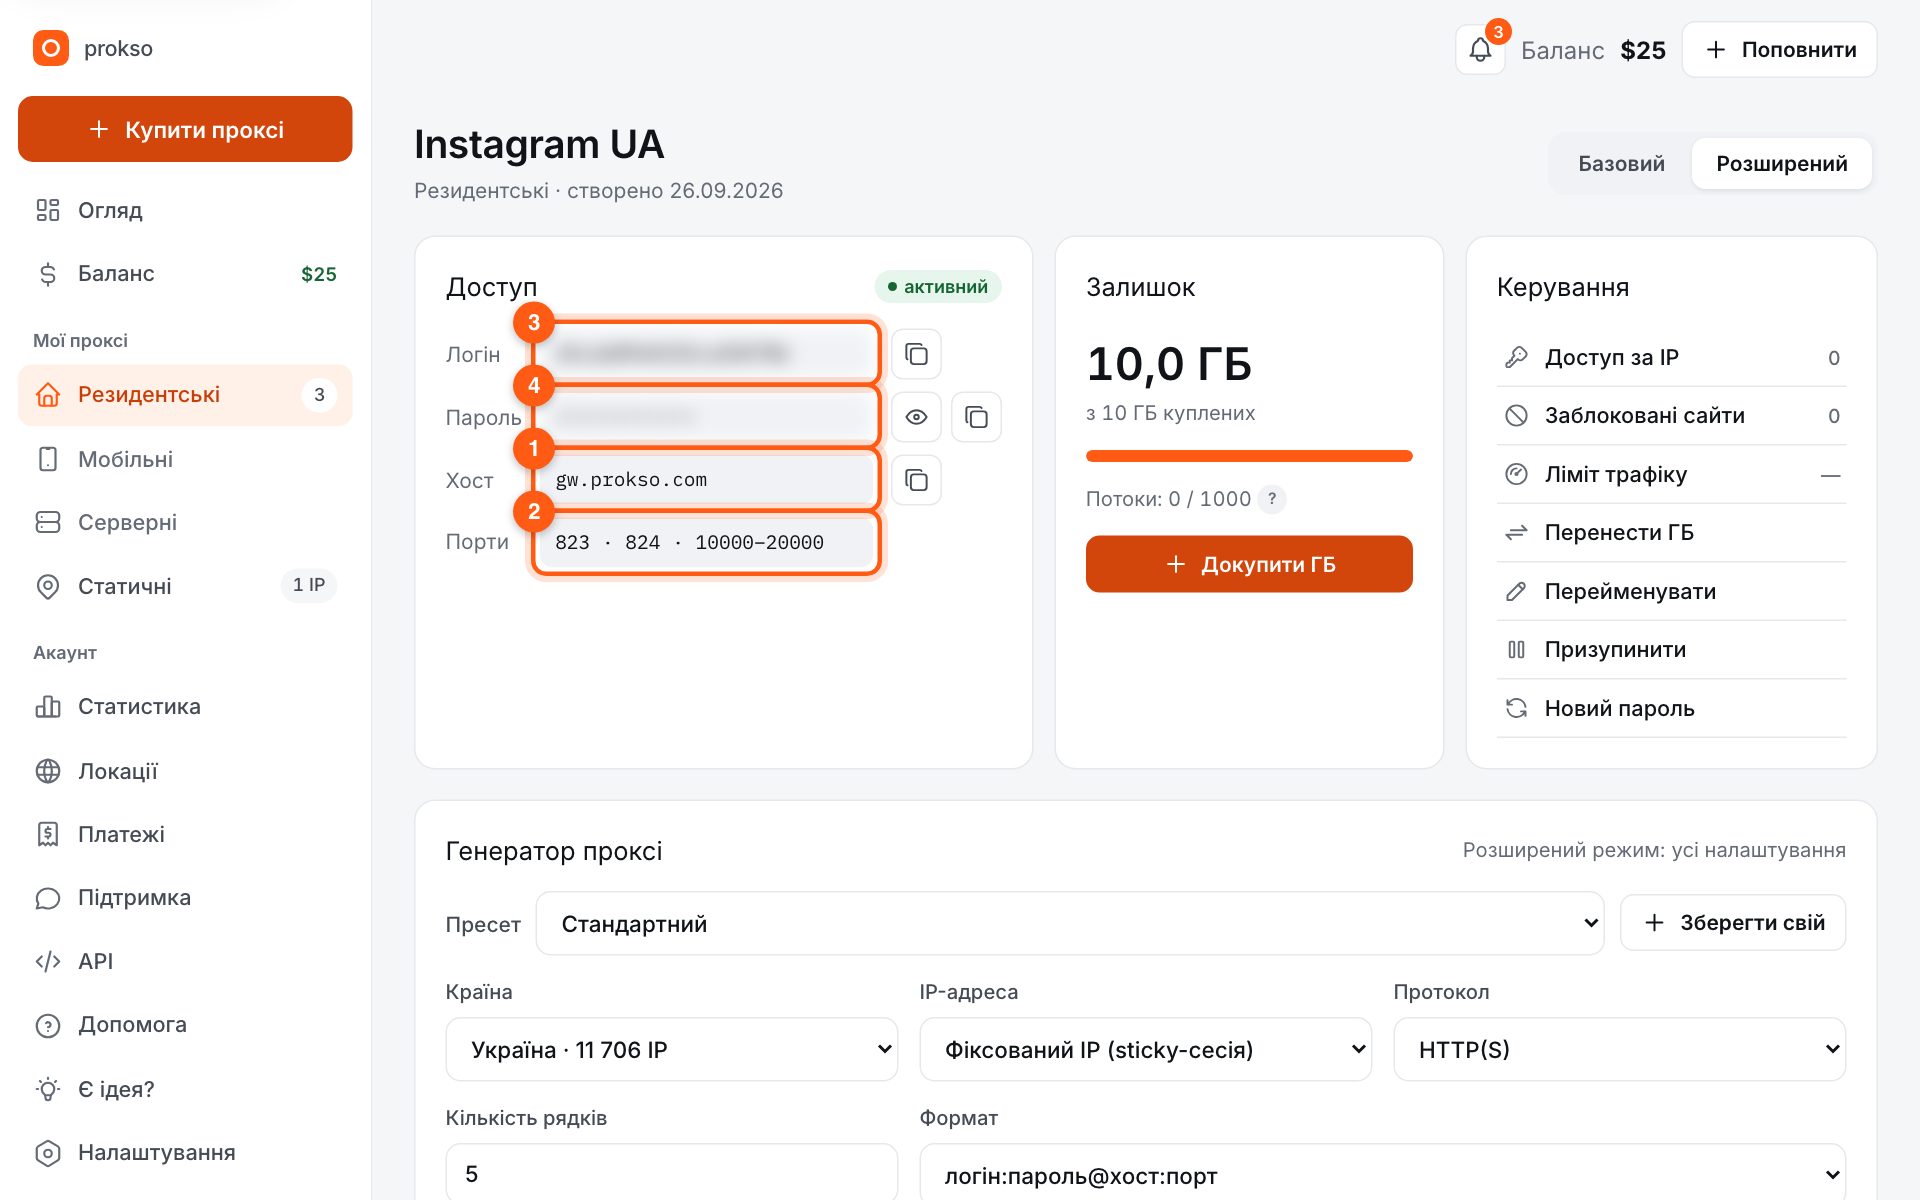
- Хост
- gw.prokso.com
- Порт
- 823 HTTP · 824 SOCKS5 — новий IP на кожен запит · 10000–20000 фіксований IP (sticky-сесія), HTTP(S) і SOCKS5
- Логін і пароль
- у кабінеті, на сторінці плану
Готові рядки у потрібному форматі генерує кабінет: оберіть країну, тип IP і протокол.
- Хост — gw.prokso.com, порти 823 (HTTP), 824 (SOCKS5), 10000–20000 (фіксований IP, HTTP або SOCKS5)
- Логін і пароль — у кабінеті на сторінці плану
- Перевіряйте IP у відповіді самого запиту через проксі: сторінка «Мій IP» у браузері ваш скрипт не перевіряє
Покрокова інструкція, як підключити проксі Prokso в Scrapy. Займе кілька хвилин.
Крок 1. Візьміть дані проксі в особистому кабінеті
Відкрийте план і скопіюйте хост gw.prokso.com, порт, логін і пароль. Порт 823 — HTTP, 824 — SOCKS5 (обидва дають новий IP на кожен запит); порти 10000–20000 — фіксований IP (sticky-сесія) до 120 хвилин, працюють і як HTTP, і як SOCKS5 (кожен порт — окрема адреса). Країну задають у логіні: логін__cr.ua.
Крок 2. Перевірте, що HttpProxyMiddleware увімкнено
У Scrapy він працює за замовчуванням (HTTPPROXY_ENABLED = True), нічого додатково встановлювати не треба. Якщо ви вимикали його в settings.py, поверніть.
Крок 3. Передайте проксі в meta запиту
Вкажіть meta={"proxy": ...} з логіном і паролем прямо в адресі. Scrapy сам перетворить їх на заголовок авторизації для проксі. Порт 823 дає новий IP на кожен запит.
import scrapy

PROXY = "http://ЛОГІН:ПАРОЛЬ@gw.prokso.com:823"

class IpSpider(scrapy.Spider):
    name = "ip"

    def start_requests(self):
        yield scrapy.Request("https://api.ipify.org?format=json",
                             meta={"proxy": PROXY})

    def parse(self, response):
        yield response.json()
Крок 4. Фіксовані IP для сесій
Якщо павук входить в акаунт або ходить по сторінках, де важливий один IP, розподіліть запити по фіксованих портах 10000–20000: одна сесія — один порт.
# one sticky port per account
PORTS = [10001, 10002, 10003]

def proxy_for(i):
    return f"http://ЛОГІН:ПАРОЛЬ@gw.prokso.com:{PORTS[i % len(PORTS)]}"

# in the request: meta={"proxy": proxy_for(i)}
Крок 5. Перевірте IP у результаті
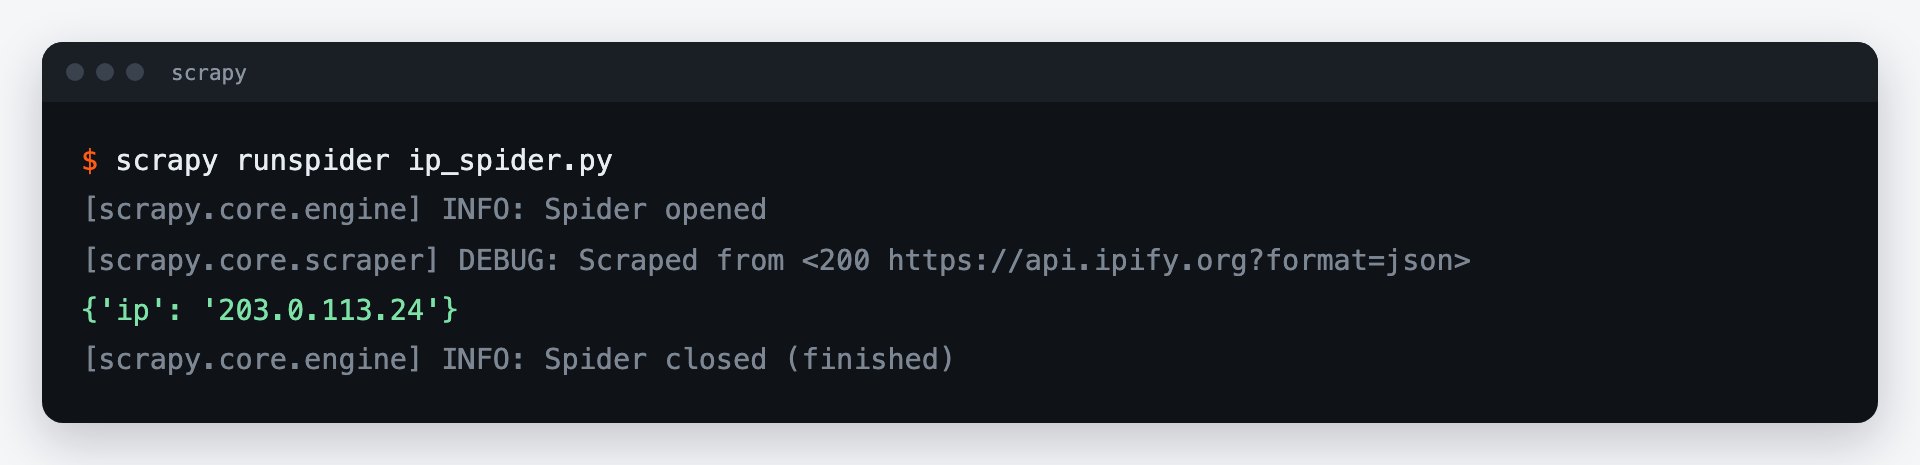
Збережіть павука з прикладу у файл ip_spider.py і запустіть scrapy runspider ip_spider.py. Він звернеться до https://api.ipify.org і виведе в лог зібраний елемент з IP — це має бути IP проксі, а не ваш.
Налаштування проєкту для роботи через проксі
Стандартні значення Scrapy розраховані на пряме з'єднання. Через проксі варто зменшити кількість одночасних запитів до одного сайту, увімкнути автоматичне підлаштування швидкості й обмежити повтори:
# settings.py
CONCURRENT_REQUESTS = 8
CONCURRENT_REQUESTS_PER_DOMAIN = 4
DOWNLOAD_TIMEOUT = 30
AUTOTHROTTLE_ENABLED = True          # slows down when the site responds slowly
RETRY_TIMES = 2
RETRY_HTTP_CODES = [502, 503, 504, 408]
COMPRESSION_ENABLED = True           # compressed responses use less traffic
У RETRY_HTTP_CODES залиште лише тимчасові збої. Коди 403 і 429 надходять від сайту: повторювати їх одразу немає сенсу, а трафік витрачається на кожну відповідь.
Проксі для всіх запитів одразу
Щоб не писати meta в кожному запиті, додайте проксі в невеликому проміжному обробнику. Він має стояти раніше за вбудований HttpProxyMiddleware:
# middlewares.py
class ProksoProxyMiddleware:
    def process_request(self, request, spider):
        request.meta.setdefault("proxy", spider.settings["PROXY_URL"])

# settings.py
PROXY_URL = "http://USERNAME:PASSWORD@gw.prokso.com:823"
DOWNLOADER_MIDDLEWARES = {"myproject.middlewares.ProksoProxyMiddleware": 350}
Як витрачати менше трафіку
Scrapy завантажує лише HTML, без картинок і скриптів, тому сам собою витрачає небагато. Основні втрати — повторні обходи. Увімкніть HTTPCACHE_ENABLED на час налагодження павука: сторінки братимуться з диска, а не через проксі. Перед запуском оцініть обсяг у калькуляторі трафіку.
Питання й відповіді
Чи можна задати проксі для всього проєкту одразу?
Так: HttpProxyMiddleware читає змінні оточення <code>http_proxy</code> і <code>https_proxy</code>. Але значення в <code>meta</code> має пріоритет, тож для окремих запитів його можна перевизначити.
Що робити з помилками 407?
Це означає, що проксі не прийняв логін або пароль. Скопіюйте їх ще раз зі сторінки плану і перевірте, що в паролі немає символів, які треба кодувати в URL.
Як змінювати IP на кожному запиті?
Нічого робити не потрібно: порт 823 видає новий IP на кожен запит. Пул проксі й окремі розширення для ротації не потрібні.
Сайт відповідає 403 на всі запити. Річ у проксі?
Зазвичай ні: це відповідь сайту. Перевірте заголовки запиту, насамперед User-Agent, зменште швидкість і спробуйте інший тип проксі. Докладніше — на сторінці <a href="/errors/403-forbidden">помилки 403</a>.
Чи працює проксі зі scrapy-playwright?
Так, але проксі там задається в параметрах запуску браузера, а не через <code>meta["proxy"]</code>.