- Host
- gw.prokso.com
- Port
- 823 HTTP · 824 SOCKS5 — nowy IP przy każdym żądaniu · 10000–20000 stały IP na całą sesję, HTTP(S) i SOCKS5
- Login i hasło
- w panelu klienta, na stronie planu
Gotowe wiersze w potrzebnym formacie wygenerujesz w panelu klienta: wybierz kraj, typ IP i protokół.
- Host gw.prokso.com, porty 823 (HTTP), 824 (SOCKS5), 10000–20000 (sesje sticky, HTTP lub SOCKS5)
- Login i hasło znajdziesz w panelu klienta na stronie planu
- Sprawdzaj IP w odpowiedzi samego żądania wysłanego przez proxy: strona Mój IP w przeglądarce nie testuje Twojego skryptu
Instrukcja krok po kroku, jak podłączyć proxy Prokso w Scrapy. Zajmie Ci to kilka minut.
Krok 1. Pobierz dane proxy z panelu klienta
Otwórz swój plan i skopiuj host gw.prokso.com, port, login i hasło. Port 823 to HTTP, a 824 to SOCKS5 (oba dają nowy IP przy każdym żądaniu); porty 10000–20000 utrzymują jeden IP (sesja sticky) do 120 minut i działają zarówno jako HTTP, jak i SOCKS5 (każdy port to osobny adres). Kraj ustawiasz w loginie: username__cr.ua.

Krok 2. Upewnij się, że HttpProxyMiddleware jest włączony
Scrapy włącza go domyślnie (HTTPPROXY_ENABLED = True), więc nie trzeba niczego doinstalowywać. Jeśli został wyłączony w settings.py, włącz go ponownie.
Krok 3. Przekaż proxy w meta żądania
Ustaw meta={"proxy": ...} z loginem i hasłem bezpośrednio w URL. Scrapy zamieni je na nagłówek autoryzacji proxy. Port 823 daje nowy IP przy każdym żądaniu.
import scrapy

PROXY = "http://USERNAME:PASSWORD@gw.prokso.com:823"

class IpSpider(scrapy.Spider):
    name = "ip"

    def start_requests(self):
        yield scrapy.Request("https://api.ipify.org?format=json",
                             meta={"proxy": PROXY})

    def parse(self, response):
        yield response.json()
Krok 4. Sesje sticky
Jeśli spider się loguje albo przechodzi przez strony, na których liczy się stały IP, rozłóż żądania na porty sticky 10000–20000: jedna sesja – jeden port.
# one sticky port per account
PORTS = [10001, 10002, 10003]

def proxy_for(i):
    return f"http://USERNAME:PASSWORD@gw.prokso.com:{PORTS[i % len(PORTS)]}"

# in the request: meta={"proxy": proxy_for(i)}
Krok 5. Sprawdź IP w wyniku
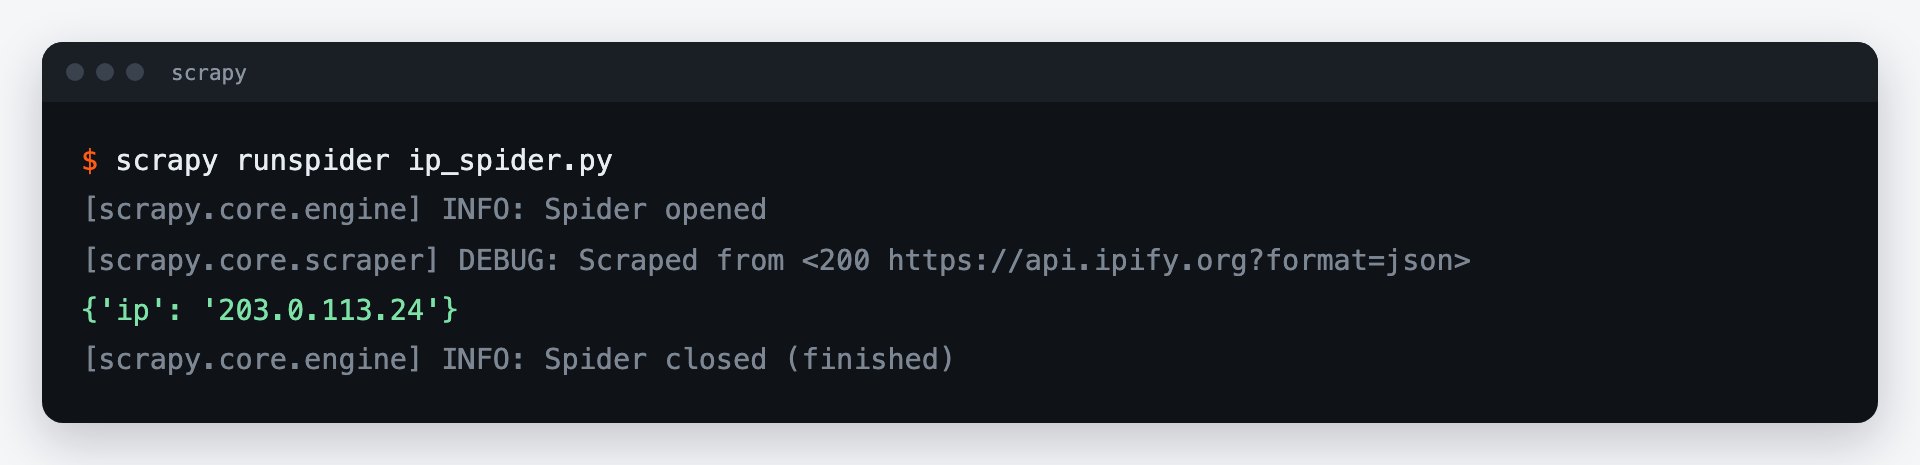
Zapisz przykładowego spidera jako ip_spider.py i uruchom scrapy runspider ip_spider.py. Wyśle on żądanie do https://api.ipify.org i zapisze w logu pobrany element z IP – powinien to być IP proxy, a nie Twój.
Ustawienia projektu do pracy przez proxy
Domyślne wartości Scrapy są dobrane pod połączenie bezpośrednie. Przy pracy przez proxy warto zmniejszyć liczbę jednoczesnych żądań do jednej strony, włączyć automatyczne dostosowanie tempa i ograniczyć liczbę ponowień:
# settings.py
CONCURRENT_REQUESTS = 8
CONCURRENT_REQUESTS_PER_DOMAIN = 4
DOWNLOAD_TIMEOUT = 30
AUTOTHROTTLE_ENABLED = True          # slows down when the site responds slowly
RETRY_TIMES = 2
RETRY_HTTP_CODES = [502, 503, 504, 408]
COMPRESSION_ENABLED = True           # compressed responses use less traffic
W RETRY_HTTP_CODES zostaw tylko chwilowe błędy. Kody 403 i 429 pochodzą od strony: natychmiastowe ponawianie nie ma sensu, a transfer zużywa się przy każdej odpowiedzi.
Proxy dla wszystkich żądań naraz
Żeby nie wpisywać meta w każdym żądaniu, dodaj proxy w małym middleware. Musi ono działać przed wbudowanym HttpProxyMiddleware:
# middlewares.py
class ProksoProxyMiddleware:
    def process_request(self, request, spider):
        request.meta.setdefault("proxy", spider.settings["PROXY_URL"])

# settings.py
PROXY_URL = "http://USERNAME:PASSWORD@gw.prokso.com:823"
DOWNLOADER_MIDDLEWARES = {"myproject.middlewares.ProksoProxyMiddleware": 350}
Jak zużywać mniej transferu
Scrapy pobiera tylko HTML, bez obrazków i skryptów, więc sam w sobie zużywa niewiele. Główne straty to powtórne crawle. Na czas debugowania spidera włącz HTTPCACHE_ENABLED: strony będą wczytywane z dysku, a nie przez proxy. Przed uruchomieniem oszacuj wolumen w kalkulatorze transferu.
Jeśli proxy nie działa
Pytania i odpowiedzi (FAQ)
Czy mogę ustawić proxy od razu dla całego projektu?
Tak: HttpProxyMiddleware odczytuje zmienne środowiskowe http_proxy i https_proxy. Wartość z meta ma pierwszeństwo, więc nadal możesz ją nadpisać dla pojedynczego żądania.
Co oznacza błąd 407?
Oznacza, że proxy odrzuciło login lub hasło. Skopiuj je ponownie ze strony planu i sprawdź, czy hasło nie zawiera znaków wymagających kodowania URL.
Jak zmieniać IP przy każdym żądaniu?
Nie musisz nic robić: port 823 daje nowy IP przy każdym żądaniu. Pula proxy ani osobne rozszerzenia do rotacji nie są potrzebne.
Strona odpowiada 403 na każde żądanie. Czy to wina proxy?
Zwykle nie: to odpowiedź samej strony. Sprawdź nagłówki żądania, przede wszystkim User-Agent, zmniejsz tempo i wypróbuj inny typ proxy. Więcej szczegółów znajdziesz na <a href="/pl/errors/403-forbidden">stronie o błędzie 403</a>.
Czy proxy działa ze scrapy-playwright?
Tak, ale tam proxy ustawia się w parametrach uruchomienia przeglądarki, a nie przez meta["proxy"].