- Host
- gw.prokso.com
- Port
- 823 HTTP · 824 SOCKS5 — nowy IP przy każdym żądaniu · 10000–20000 stały IP na całą sesję, HTTP(S) i SOCKS5
- Login i hasło
- w panelu klienta, na stronie planu
Gotowe wiersze w potrzebnym formacie wygenerujesz w panelu klienta: wybierz kraj, typ IP i protokół.
- Host gw.prokso.com, porty 823 (HTTP), 824 (SOCKS5), 10000–20000 (sesje sticky, HTTP lub SOCKS5)
- Login i hasło znajdziesz w panelu klienta na stronie planu
- Sprawdzaj IP w odpowiedzi na samo żądanie wysłane przez proxy: strona „Mój IP” w przeglądarce nie testuje Twojego skryptu
Instrukcja krok po kroku, jak podłączyć proxy Prokso w Python requests. Zajmie Ci to kilka minut.
Krok 1. Pobierz dane proxy z panelu klienta
Otwórz swój plan i skopiuj host gw.prokso.com, port, login i hasło. Port 823 to HTTP, a 824 to SOCKS5 (oba dają nowy IP przy każdym żądaniu); porty 10000–20000 utrzymują jeden IP (sesja sticky) przez maksymalnie 120 minut i działają zarówno jako HTTP, jak i SOCKS5 (każdy port to osobny adres). Kraj ustawiasz w loginie: username__cr.ua.

Krok 2. Zainstaluj bibliotekę
Potrzebujesz Pythona 3 i biblioteki requests: pip install requests. Dla SOCKS5: pip install "requests[socks]".
Krok 3. Przekaż proxy do żądania
Wpisz proxy do słownika proxies dla http i https. Poniższy kod wypisuje IP, który widzi strona.
import requests

proxy = "http://USERNAME:PASSWORD@gw.prokso.com:823"
proxies = {"http": proxy, "https": proxy}

r = requests.get("https://api.ipify.org?format=json", proxies=proxies, timeout=30)
print(r.json())
Krok 4. SOCKS5 i sesja sticky
Dla SOCKS5 zmień schemat na socks5h://, a port na 824. Aby wysłać kilka żądań z jednego IP, użyj zamiast 823 lub 824 portu z zakresu 10000–20000 – działa zarówno z http://, jak i z socks5h://.
# pip install "requests[socks]"
proxy = "socks5h://USERNAME:PASSWORD@gw.prokso.com:824"   # socks5h — DNS through the proxy too
Krok 5. Sprawdź wynik skryptu
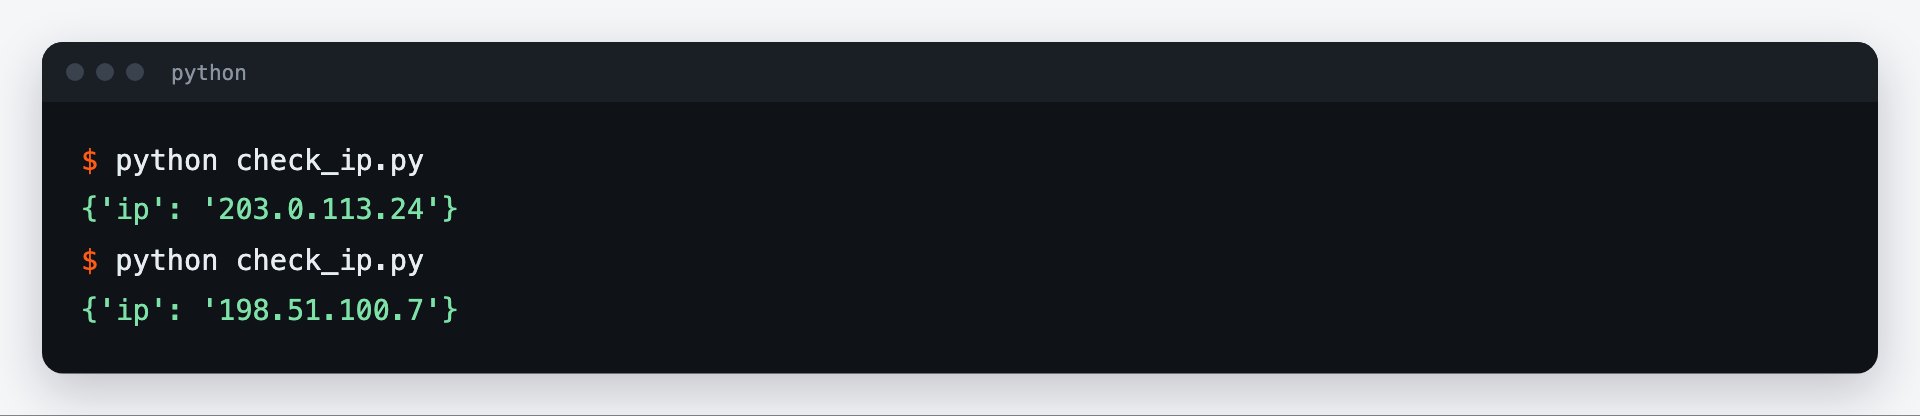
Uruchom kod z kroku 3: wysyła on przez proxy żądanie do https://api.ipify.org i wypisuje {"ip": "…"} – adres, który widzi strona. Powinien różnić się od Twojego. Uruchom go dwa razy: na porcie 823 IP się zmienia, na porcie sticky pozostaje ten sam. Strona „Mój IP” w przeglądarce tu nie pomoże, bo przeglądarka nie korzysta z tego proxy.
Sesja, limity czasu i ponowienia
Przy serii żądań utwórz requests.Session() i ustaw proxy raz: sesja ponownie wykorzystuje połączenia i działa zauważalnie szybciej. Zawsze ustawiaj timeout: bez niego zawieszone żądanie zatrzyma skrypt na zawsze. Przez adresy rezydencjalne i mobilne odpowiedź przychodzi wolniej niż bezpośrednio, więc 30 sekund to rozsądny punkt wyjścia.
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

proxy = "http://USERNAME:PASSWORD@gw.prokso.com:823"

s = requests.Session()
s.proxies = {"http": proxy, "https": proxy}
# retry only temporary failures, with a growing pause
retry = Retry(total=3, backoff_factor=1, status_forcelist=[502, 503, 504])
s.mount("http://", HTTPAdapter(max_retries=retry))
s.mount("https://", HTTPAdapter(max_retries=retry))

r = s.get("https://prokso.com/ip", timeout=30)
print(r.status_code, r.text)
Ponawiać warto tylko przy przejściowych błędach: 502, 503, 504 i przekroczeniu limitu czasu. Na porcie 823 każde ponowienie wychodzi z nowego IP. Kody 403 i 429 zwraca strona: natychmiastowe ponowienie ich nie naprawi, a jedynie zużyje transfer.
Co oznaczają błędy
- ProxyError z kodem 407. Proxy nie zaakceptowało loginu lub hasła. Sprawdź linię proxy i pozostały transfer w planie.
- ConnectTimeout. Skrypt nie mógł połączyć się z proxy: sprawdź host i port oraz to, czy port nie jest zablokowany w Twojej sieci.
- ReadTimeout. Proxy jest osiągalne, ale strona nie odpowiedziała na czas. Zwiększ timeout lub ponów żądanie.
- Missing dependencies for SOCKS support. Nie jest zainstalowany pakiet do obsługi SOCKS: uruchom
pip install "requests[socks]".
Kody odpowiedzi są wyjaśnione na stronie kody błędów proxy.
Jak zużywać mniej transferu
Transfer liczy się według rozmiaru odpowiedzi. Pobieraj dane przez API strony, jeśli je udostępnia: JSON jest kilka razy lżejszy niż strona HTML. Nie pobieraj ponownie tego, co już masz, i nie ładuj obrazów, jeśli potrzebujesz tylko tekstu. Kalkulator transferu pomoże Ci z góry oszacować wolumen.
ThreadPoolExecutor: jedna Session i jeden IP na workera
requests nie obiecuje, że jedną Session można bezpiecznie dzielić między wątkami. Twórz sesję dla każdego wątku przez threading.local() i daj każdemu workerowi własny numer sesji w loginie: jeden worker trzyma swój IP przez około 30 minut, a różni workerzy wychodzą z różnych adresów.
import os
import threading
from concurrent.futures import ThreadPoolExecutor
from urllib.parse import quote

import requests

USER = "USERNAME"
PASSWORD = os.environ["PROKSO_PASSWORD"]  # export PROKSO_PASSWORD=... przed uruchomieniem
local = threading.local()


def session_for_worker():
    if not hasattr(local, "s"):
        worker = threading.current_thread().name.split("_")[-1]
        login = f"{USER}__cr.us;sessid.w{worker}"  # własny IP dla workera na około 30 minut
        proxy = f"http://{quote(login, safe='')}:{quote(PASSWORD, safe='')}@gw.prokso.com:823"
        s = requests.Session()
        s.trust_env = False  # ignoruj HTTP_PROXY z systemu
        s.proxies = {"http": proxy, "https": proxy}
        local.s = s
    return local.s


def fetch(url):
    r = session_for_worker().get(url, timeout=30)
    return url, r.status_code, len(r.content)


urls = [f"https://example.com/item/{n}" for n in range(1, 41)]
with ThreadPoolExecutor(max_workers=4, thread_name_prefix="w") as pool:
    for url, code, size in pool.map(fetch, urls):
        print(code, size, url)
Hasło pochodzi ze zmiennej środowiskowej, a quote(..., safe="") koduje je razem ze znakiem ; w loginie. trust_env = False pilnuje, żeby systemowe HTTP_PROXY nie podmieniło twojego adresu. max_workers to liczba jednoczesnych żądań: dla jednej strony trzymaj ją niską.
Ciche wycieki i błędy parsowania adresu w requests
Te błędy albo w ogóle nie wyglądają na błędy, albo łatwo zrzucić je na proxy:
- W
proxiesjest tylko klucz „http”. Wtedy żądania do stron nahttps://idą bezpośrednio, bez żadnego błędu, z twojego własnego IP. Zawsze ustawiaj oba klucze i sprawdzaj IP przezhttps://api.ipify.orgw tej samej sesji. - SSLError zaraz przy łączeniu z proxy. Adres proxy zaczyna się od
https://, więc requests próbuje otworzyć TLS do samego proxy. Wpisuj w adresie proxyhttp://także dla stron https: połączenie ze stroną i tak jest szyfrowane od końca do końca wewnątrz tunelu. - InvalidProxyURL:
Please check proxy URL. It is malformed and could be missing the host.Niezakodowany@lub/w haśle zepsuł adres. Buduj go przezquote(), jak w przykładzie. - ProxyError z
Tunnel connection failedi kodem innym niż 407. Proxy odmówiło otwarcia tunelu do strony: jest ona na liście zablokowanych stron albo działa na zamkniętym porcie (porty pocztowe są zamknięte). - 429 i 403. Zwraca je strona. Przy 429 sprawdź nagłówek
Retry-Afteri wstrzymaj tego workera; przy 403 zwolnij i sprawdź zasady strony.
Rotacja, sessid i tempo dla scrapera na requests
Port 823 bez numeru sesji daje nowy IP przy każdym żądaniu: to pasuje do niezależnych stron, na przykład kart produktów. Numer sesji na workera przyda się przy paginacji i wszystkim, co opiera się na cookies. Do zadań dłuższych niż 30 minut weź port ze stałym IP z zakresu 10000-20000 na workera i ustaw czas utrzymania w panelu.
requests domyślnie prosi o skompresowane odpowiedzi (nagłówek Accept-Encoding z gzip i deflate), więc nie zastępuj go wartością identity: strona wyśle więcej bajtów, a transfer liczy się w obie strony. Linia wyniku w przykładzie wypisuje rozmiar każdej odpowiedzi – tak widać, które strony są najcięższe.
Jeśli proxy nie działa
Pytania i odpowiedzi (FAQ)
Jak uruchomić wiele wątków?
Użyj concurrent.futures albo asyncio z aiohttp. Każdy wątek może korzystać z tego samego portu 823 – każdy dostanie inny IP.
Dlaczego requests łączy się przez proxy, choć go nie ustawiłem?
Biblioteka odczytuje zmienne środowiskowe HTTP_PROXY i HTTPS_PROXY. Aby to wyłączyć, ustaw w sesji trust_env = False.
Jak zakodować znaki specjalne w haśle?
Przepuść login i hasło przez urllib.parse.quote(..., safe=""), zanim złożysz adres proxy. W przeciwnym razie znaki @ i : zepsują parsowanie adresu.
Jak ustawić kraj w kodzie?
Kraj zapisuje się w loginie, np. USERNAME__cr.de. Zmieniasz tylko login – adres i port pozostają bez zmian.
Czy mogę dzielić jedną Session między wątkami?
Lepiej nie. requests nie gwarantuje bezpieczeństwa wątkowego sesji, a z jedną sesją wszystkie wątki dzielą też cookies. Twórz sesję dla każdego wątku, jak w przykładzie.
Dlaczego IP workera zmienił się przed upływem 30 minut?
Adres rezydencjalny lub mobilny należy do prawdziwego urządzenia i jeśli ono opuści sieć, sesja dostaje nowy IP z tego samego kraju. Pisz kod tak, żeby worker mógł powtórzyć ostatni krok, na przykład zalogować się ponownie.
Czy połączenie ze stroną https przez proxy http:// jest szyfrowane?
Tak. requests otwiera tunel przez proxy metodą CONNECT, a TLS działa między twoim skryptem a stroną. Proxy widzi nazwę domeny, ale nie treść stron ani haseł.